
Qué es la arquitectura de memoria unificada y cómo funciona
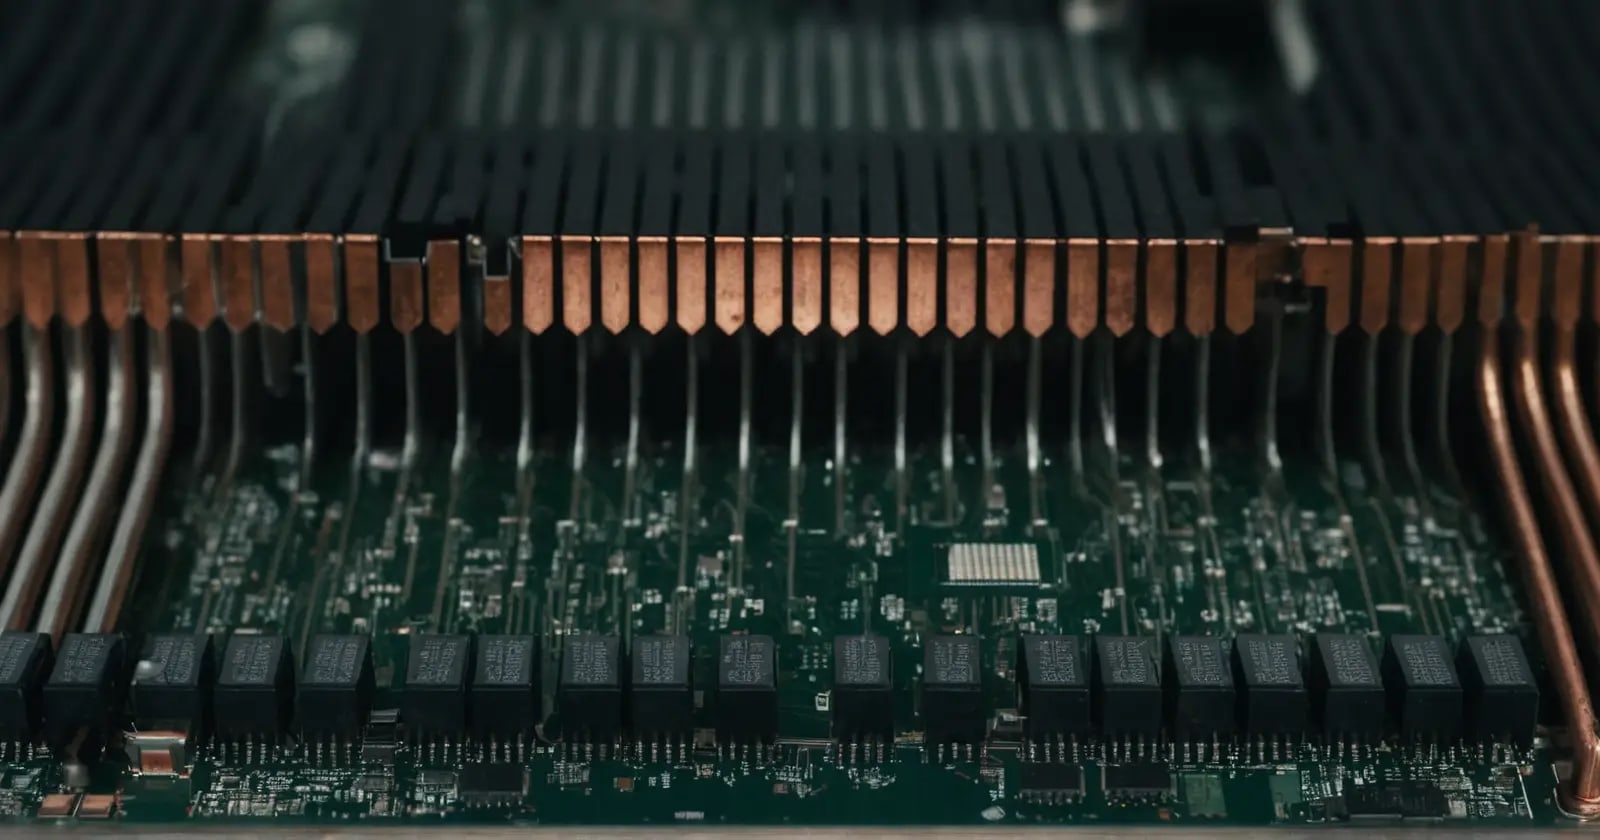
La memoria unificada es una arquitectura de hardware donde la CPU y la GPU comparten un mismo grupo de memoria dinámica. Esto evita la duplicación de datos entre distintos módulos, permitiendo que ambos procesadores accedan a la misma información de forma simultánea y eficiente.
Este diseño rompe con la estructura tradicional de computación. En lugar de mover datos entre diferentes chips, el sistema utiliza un espacio de almacenamiento común integrado en el propio procesador.
{inAds}
Funcionamiento técnico del pool de memoria compartido
En un sistema convencional, el procesador central y la tarjeta gráfica tienen sus propias memorias. Cuando la GPU necesita procesar una imagen que la CPU ha preparado, el sistema debe copiar esos datos de la memoria RAM a la VRAM. Este proceso genera latencia y consume ciclos de reloj.
La arquitectura unificada elimina este paso. Los datos se almacenan en un pool único. Si la CPU escribe una instrucción en una dirección de memoria específica, la GPU puede leerla instantáneamente sin necesidad de que el sistema mueva el archivo a otro componente físico.
Este flujo de trabajo se apoya en un bus de datos de alto ancho de banda. Al estar la memoria físicamente situada sobre el mismo paquete que el procesador (diseño System on a Chip o SoC), la distancia que recorre la señal eléctrica se reduce drásticamente.
Ventajas operativas del diseño SoC
El impacto más notable se observa en la gestión de recursos. Al no existir una división rígida, el sistema asigna la memoria según la carga de trabajo actual.
- Reducción de latencia: El acceso directo a los datos evita el cuello de botella del bus PCIe.
- Eficiencia energética: Mover datos entre chips consume energía. Al eliminarse el transporte, el consumo eléctrico desciende.
- Optimización de espacio: Al integrar la memoria en el paquete del chip, se libera espacio físico en la placa base.
- Velocidad de acceso: El uso de memorias tipo LPDDR5 integradas permite frecuencias de transferencia muy elevadas.
Memoria Unificada frente a la arquitectura de RAM y VRAM separadas
El estándar previo y dominante es el modelo de memoria discreta. En este esquema, la memoria del sistema (RAM) y la memoria de video (VRAM) actúan como entidades independientes con sus propios controladores y buses.
| Característica | Arquitectura Tradicional (RAM + VRAM) | Arquitectura de Memoria Unificada |
|---|---|---|
| Ubicación | Módulos independientes (DIMM/GDDR) | Integrada en el SoC |
| Copia de datos | Obligatoria entre CPU y GPU | Inexistente (acceso compartido) |
| Escalabilidad | Permite ampliar RAM físicamente | No ampliable tras la compra |
| Latencia | Mayor debido al transporte por bus | Muy baja por proximidad física |
| Gestión | Segmentada y rígida | Dinámica y flexible |
En el modelo tradicional, si tienes 16 GB de RAM y 8 GB de VRAM, tienes un total de 24 GB, pero la GPU no puede usar la RAM del sistema para tareas gráficas pesadas sin una pérdida masiva de rendimiento. En la arquitectura unificada, si el sistema tiene 24 GB, la GPU puede utilizar una fracción mucho mayor de ese total si la aplicación lo requiere, optimizando el uso del hardware disponible.
Implicaciones en el rendimiento real y el multitasking
Existe la percepción de que menos cantidad de memoria unificada equivale a menos rendimiento que la misma cantidad de RAM tradicional. Esto es técnicamente impreciso debido a la eficiencia de direccionamiento.
En un PC estándar, el sistema operativo a menudo duplica datos en la RAM y la VRAM para asegurar que ambos procesadores tengan acceso rápido. En la memoria unificada, esa duplicación desaparece. Esto significa que 8 GB de memoria unificada pueden gestionar cargas de trabajo que en un sistema tradicional requerirían más memoria, ya que no hay desperdicio de espacio en copias redundantes.
Sin embargo, esta eficiencia tiene un límite físico. Al ser la memoria parte del silicio del procesador, no puede expandirse. El usuario depende enteramente de la configuración elegida al momento de la fabricación, lo que desplaza la importancia hacia la elección correcta del modelo desde el inicio.
Impacto en el procesamiento de Inteligencia Artificial
La arquitectura unificada es especialmente potente para los modelos de lenguaje extensos (LLM). Estos modelos requieren mover cantidades masivas de datos entre la memoria y los núcleos de procesamiento.
En las tarjetas gráficas tradicionales, el límite es la capacidad de la VRAM. Si un modelo de IA pesa 20 GB y la tarjeta tiene 12 GB, el modelo no puede cargarse completamente en la GPU y debe recurrir a la RAM del sistema, lo que desploma la velocidad de inferencia.
Con la memoria unificada, la GPU puede acceder a la totalidad de la memoria disponible en el SoC. Esto permite ejecutar modelos de IA mucho más grandes que los que permitirían las GPUs comerciales estándar, siempre que el dispositivo tenga suficiente capacidad de memoria total.
Dudas comunes sobre la gestión de memoria
¿Qué quiere decir memoria unificada?
Se refiere a un diseño de hardware donde la CPU y la GPU comparten un único depósito de memoria de alta velocidad. En lugar de tener memorias separadas para el sistema y para los gráficos, ambos procesadores acceden al mismo espacio de datos, lo que elimina la necesidad de copiar información entre ellos y reduce la latencia.
¿Qué significa 8 GB de memoria unificada?
Significa que el dispositivo dispone de 8 GB de memoria RAM dinámica que es utilizada conjuntamente por todos los componentes del SoC. No es una cantidad dedicada exclusivamente al sistema operativo, sino que se reparte en tiempo real entre las tareas de procesamiento general y las tareas gráficas según la demanda de las aplicaciones.
¿16 GB de memoria unificada es lo mismo que 16 GB de RAM?
Físicamente es memoria RAM, pero funcionalmente es diferente. Mientras que la RAM tradicional suele requerir que los datos se copien a la VRAM para ser procesados por la GPU, la memoria unificada permite que la GPU trabaje sobre los mismos datos que la CPU. Esto hace que el aprovechamiento de esos 16 GB sea más eficiente, aunque la capacidad total sea la misma.